
You're absolutely right. I apologize for the oversight. Let me provide the complete Chapter 25 with all three diagram placeholders and their corresponding detailed image-generation prompts.
Chapter 25: Vector Search and Embeddings
---# Chapter 25: Vector Search and Embeddings
In the previous chapter, we explored AI-ready data modeling and learned how to design data models optimized for machine learning workloads, including feature stores and MLOps integration.
In this chapter, we will dive into Vector Search and Embeddings—understanding how to represent data as vectors, perform semantic similarity searches, and build intelligent applications that understand meaning rather than just keywords.
Using our Digital Banking Platform case study, we will implement vector search for fraud detection, semantic document retrieval, intelligent customer support, and personalized recommendations.
🎯 Learning Objectives
By the end of this chapter, you will be able to:
- Understand vector embeddings and their role in AI applications
- Generate embeddings using Google Cloud's embedding models
- Implement vector search in BigQuery and Vertex AI
- Design vector databases for banking use cases
- Build semantic search and recommendation systems
- Apply vector search for fraud detection and anomaly detection
- Implement Retrieval-Augmented Generation (RAG) workflows
- Apply best practices for vector search and embeddings
What are Vector Embeddings?
Vector embeddings are numerical representations of data that capture semantic meaning, enabling computers to understand relationships and similarities between data points.
Vector Embedding = Numerical Representation + Semantic Meaning + High-Dimensional Space
Think of vector embeddings as:
- A way to translate human meaning into numbers
- A map where similar concepts are close together
- The foundation of modern AI and semantic search
- How computers "understand" language, images, and context
Real-World Banking Example
A bank needs to find similar transactions for fraud investigation:
Traditional Keyword Search:
Search for "suspicious transaction"
→ Returns exact matches only
→ Misses semantically similar patterns

Vector Search Approach:
Convert transactions to embeddings
Search for semantically similar transactions
→ Finds patterns that look like fraud
→ Catches sophisticated fraud rings
How Embeddings Work
The Concept
Embedding Models convert data into vectors (lists of numbers)

Example: Text → Embedding
"fraudulent transaction" → [0.23, -0.45, 0.67, ...]
"suspicious payment"   → [0.21, -0.43, 0.69, ...]
"legitimate purchase"  → [-0.12, 0.34, -0.56, ...]

Similar texts → Similar vectors (close in vector space)
Different texts → Different vectors (far apart)
Embedding Dimensions
Dimensionality: Number of numbers in the vector
- Higher dimensions = More nuanced representation
- Lower dimensions = Faster, less storage

Common Dimensions:
- 384 (small, fast)
- 768 (medium, balanced)
- 1536 (large, high quality)

Banking Example:
- Text embeddings: 768 dimensions
- Transaction embeddings: 256 dimensions
Google Cloud Embedding Models
Vertex AI Embedding Models
1. text-embedding-005
   - Google's latest text embedding model
   - High quality, multilingual support
   - 768 dimensions
   - Good for general text similarity

2. text-multilingual-embedding-002
   - Multilingual support
   - 768 dimensions
   - Good for international banking

3. Gemini Embedding Models
   - Powered by Gemini
   - Highest quality
   - Available in BigQuery

4. Open-Source Models (13,000+)
   - Directly usable in BigQuery
   - Flexible options
Generating Embeddings in BigQuery
-- Generate embeddings using BigQuery ML
CREATE OR REPLACE MODEL banking.embedding_model
REMOTE WITH CONNECTION `your-connection`
OPTIONS (
  endpoint = 'aiplatform.googleapis.com/v1/projects/your-project/locations/us-central1/publishers/google/models/text-embedding-005'
);

-- Generate embeddings for transaction descriptions
CREATE OR REPLACE TABLE banking.transaction_embeddings
AS
SELECT
  transaction_id,
  transaction_description,
  ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    transaction_description
  ) AS embedding,
  transaction_amount,
  transaction_date,
  customer_id
FROM banking.transactions;

-- Generate embeddings with Gemini in BigQuery
CREATE OR REPLACE TABLE banking.customer_query_embeddings
AS
SELECT
  query_id,
  query_text,
  ML.GENERATE_EMBEDDING(
    MODEL banking.gemini_embedding_model,
    query_text
  ) AS embedding
FROM banking.customer_queries;
Vector Search on Google Cloud
BigQuery Vector Search
BigQuery now provides native vector search capabilities, allowing you to generate embeddings and perform semantic searches directly within your data warehouse.
-- Create a vector index on embeddings
CREATE VECTOR INDEX transaction_embedding_index
ON banking.transaction_embeddings(embedding)
OPTIONS (
  distance_type = 'COSINE',
  index_type = 'IVF'
);

-- Semantic search using VECTOR_SEARCH
SELECT
  base.transaction_id,
  base.transaction_description,
  base.transaction_amount,
  APPROX_DISTANCE(
    base.embedding,
    (SELECT embedding FROM banking.transaction_embeddings WHERE transaction_id = 'TXN001')
  ) AS similarity_score
FROM banking.transaction_embeddings AS base
ORDER BY similarity_score
LIMIT 10;

-- Search by semantic meaning
DECLARE query_embedding ARRAY<FLOAT64>;

SET query_embedding = (
  SELECT ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    'suspicious international wire transfer'
  )
);

SELECT
  transaction_id,
  transaction_description,
  transaction_amount,
  APPROX_DISTANCE(embedding, query_embedding) AS similarity
FROM banking.transaction_embeddings
ORDER BY similarity
LIMIT 10;
Vertex AI Vector Search
Vertex AI Vector Search (formerly Matching Engine) is Google's managed service for high-scale, low-latency vector similarity search.
-- Prepare data for Vertex AI Vector Search
-- 1. Create embeddings and export to Cloud Storage
CREATE OR REPLACE TABLE banking.vertex_embeddings
AS
SELECT
  transaction_id AS datapoint_id,
  embedding,
  -- Add metadata for filtering
  STRUCT(
    transaction_amount AS amount,
    customer_id AS customer_id,
    merchant_category AS merchant_category,
    transaction_date AS date
  ) AS restricts
FROM banking.transaction_embeddings;

-- 2. Export to Cloud Storage
EXPORT DATA OPTIONS(
  uri='gs://banking-embeddings/transactions/*',
  format='JSON'
) AS
SELECT
  datapoint_id,
  TO_JSON_STRING(embedding) AS embedding,
  TO_JSON_STRING(restricts) AS restricts
FROM banking.vertex_embeddings;

-- 3. Use Vertex AI Vector Search for queries
-- gcloud ai indexes create \
--   --display-name=transaction-index \
--   --metadata-file=gs://banking-embeddings/transactions/metadata.json \
--   --contents-file=gs://banking-embeddings/transactions/contents/
Banking Vector Search Use Cases
Use Case 1: Fraud Detection with Vector Similarity
-- Find transactions similar to known fraud patterns
CREATE OR REPLACE TABLE banking.fraud_similarity_search
AS
WITH fraud_patterns AS (
  SELECT
    transaction_id,
    embedding,
    transaction_description
  FROM banking.transaction_embeddings
  WHERE is_fraud_label = TRUE
),
all_transactions AS (
  SELECT
    transaction_id,
    embedding,
    transaction_description,
    transaction_amount,
    customer_id,
    transaction_date
  FROM banking.transaction_embeddings
)
SELECT
  a.transaction_id,
  a.transaction_description,
  a.transaction_amount,
  a.customer_id,
  a.transaction_date,
  MIN(APPROX_DISTANCE(a.embedding, f.embedding)) AS min_fraud_similarity,
  AVG(APPROX_DISTANCE(a.embedding, f.embedding)) AS avg_fraud_similarity
FROM all_transactions a
CROSS JOIN fraud_patterns f
WHERE a.is_fraud_label = FALSE
  AND a.transaction_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 7 DAY)
GROUP BY a.transaction_id, a.transaction_description, a.transaction_amount,
         a.customer_id, a.transaction_date
HAVING min_fraud_similarity < 0.3  -- Close to fraud patterns
ORDER BY avg_fraud_similarity ASC
LIMIT 100;
Use Case 2: Intelligent Document Search
-- Semantic search across banking documents
CREATE OR REPLACE TABLE banking.document_embeddings
AS
SELECT
  document_id,
  document_title,
  document_content,
  document_category,
  ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    document_content
  ) AS embedding,
  created_date
FROM banking.documents;

-- Search for documents by semantic meaning
DECLARE query_embedding ARRAY<FLOAT64>;

SET query_embedding = (
  SELECT ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    'How to apply for a mortgage loan?'
  )
);

SELECT
  document_title,
  document_category,
  created_date,
  APPROX_DISTANCE(embedding, query_embedding) AS relevance
FROM banking.document_embeddings
ORDER BY relevance
LIMIT 5;
Use Case 3: Customer Support with RAG
-- RAG (Retrieval-Augmented Generation) for customer support
CREATE OR REPLACE TABLE banking.support_knowledge_base
AS
SELECT
  article_id,
  article_title,
  article_content,
  article_category,
  ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    article_content
  ) AS embedding,
  created_date,
  updated_date
FROM banking.support_articles;

-- Retrieve relevant articles for a customer query
DECLARE customer_question STRING;
DECLARE question_embedding ARRAY<FLOAT64>;

SET customer_question = 'I lost my debit card. How do I block it?';
SET question_embedding = (
  SELECT ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    customer_question
  )
);

SELECT
  article_title,
  article_category,
  APPROX_DISTANCE(embedding, question_embedding) AS relevance
FROM banking.support_knowledge_base
ORDER BY relevance
LIMIT 3;
Use Case 4: Personalized Recommendations
-- Customer transaction similarity for recommendations
CREATE OR REPLACE TABLE banking.customer_behavior_embeddings
AS
SELECT
  customer_id,
  ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    CONCAT(
      'Customer segment: ', customer_segment,
      ' - Products: ', products_held,
      ' - Avg transaction: ', CAST(avg_transaction_amount AS STRING),
      ' - Categories: ', categories
    )
  ) AS behavior_embedding,
  customer_segment,
  products_held,
  avg_transaction_amount
FROM banking.customer_behavior_summary;

-- Find similar customers for targeted offers
DECLARE target_customer_id STRING;
DECLARE target_embedding ARRAY<FLOAT64>;

SET target_customer_id = 'C001';
SET target_embedding = (
  SELECT behavior_embedding
  FROM banking.customer_behavior_embeddings
  WHERE customer_id = target_customer_id
);

SELECT
  customer_id,
  customer_segment,
  products_held,
  APPROX_DISTANCE(behavior_embedding, target_embedding) AS similarity
FROM banking.customer_behavior_embeddings
WHERE customer_id != target_customer_id
ORDER BY similarity
LIMIT 10;
Embedding Generation Pipeline
Complete Embedding Pipeline
-- Step 1: Raw Data Preparation
CREATE OR REPLACE TABLE banking.embedding_source_data
AS
SELECT
  transaction_id,
  CONCAT(
    'Transaction of ', CAST(transaction_amount AS STRING),
    ' at ', merchant_name,
    ' in category ', merchant_category,
    ' on ', CAST(transaction_date AS STRING)
  ) AS embedding_text,
  transaction_amount,
  merchant_category,
  customer_id,
  transaction_date
FROM banking.transactions
WHERE transaction_date >= DATE_SUB(CURRENT_DATE(), INTERVAL 90 DAY);

-- Step 2: Generate Embeddings
CREATE OR REPLACE TABLE banking.transaction_embeddings_latest
AS
SELECT
  transaction_id,
  ML.GENERATE_TEXT_EMBEDDING(
    MODEL banking.embedding_model,
    embedding_text
  ) AS embedding,
  transaction_amount,
  merchant_category,
  customer_id,
  transaction_date,
  embedding_text
FROM banking.embedding_source_data;

-- Step 3: Create Vector Index for Performance
CREATE VECTOR INDEX transaction_embedding_index_latest
ON banking.transaction_embeddings_latest(embedding)
OPTIONS (
  distance_type = 'COSINE',
  index_type = 'IVF',
  ivf_options = '{"num_lists": 100}'
);

-- Step 4: Monitor Embedding Quality
CREATE OR REPLACE TABLE banking.embedding_quality_metrics
AS
SELECT
  COUNT(*) AS total_embeddings,
  AVG(ARRAY_LENGTH(embedding)) AS avg_dimensions,
  COUNT(DISTINCT customer_id) AS unique_customers,
  MIN(transaction_date) AS earliest_transaction,
  MAX(transaction_date) AS latest_transaction,
  CURRENT_TIMESTAMP() AS check_time
FROM banking.transaction_embeddings_latest;
Vector Index Types
Index Types Comparison
| Index Type | Description | Best For | Performance |
|---|---|---|---|
| IVF (Inverted File Index) | Partitions vectors into clusters | Large datasets | Good recall, fast search |
| HNSW (Hierarchical Navigable Small World) | Graph-based indexing | High recall requirements | Excellent recall, slower build |
| ScaNN | Google's proprietary index | Google Cloud services | Blazing fast, high scale |
| Flat Index | Exact nearest neighbor | Small datasets | Perfect recall, slow for large |
Creating Different Index Types
-- IVF Index (Good for large datasets)
CREATE VECTOR INDEX transactions_ivf_idx
ON banking.transaction_embeddings(embedding)
OPTIONS (
  distance_type = 'COSINE',
  index_type = 'IVF',
  ivf_options = '{"num_lists": 100}'
);

-- HNSW Index (Higher recall)
CREATE VECTOR INDEX transactions_hnsw_idx
ON banking.transaction_embeddings(embedding)
OPTIONS (
  distance_type = 'COSINE',
  index_type = 'HNSW',
  hnsw_options = '{"m": 16, "ef_construction": 200}'
);
Vector Search Best Practices
| # | Best Practice | Banking Example |
|---|---|---|
| 1 | Choose the right embedding model | text-embedding-005 for text |
| 2 | Normalize embeddings | Use cosine distance |
| 3 | Create vector indexes | IVF for large datasets |
| 4 | Batch generate embeddings | Efficient processing |
| 5 | Monitor embedding quality | Quality metrics table |
| 6 | Version embeddings | Track model versions |
| 7 | Use metadata filtering | Customer, date filters |
| 8 | Optimize for latency | HNSW for low latency |
Common Mistakes
| # | Common Mistake | Better Approach |
|---|---|---|
| 1 | Not normalizing embeddings | Always normalize |
| 2 | Using wrong distance metric | Cosine for normalized |
| 3 | No vector index | Create index for performance |
| 4 | Embedding drift | Monitor and retrain |
| 5 | Too high dimensions | Use appropriate model |
| 6 | No metadata filtering | Use restricts |
| 7 | Batch too large | Chunk processing |
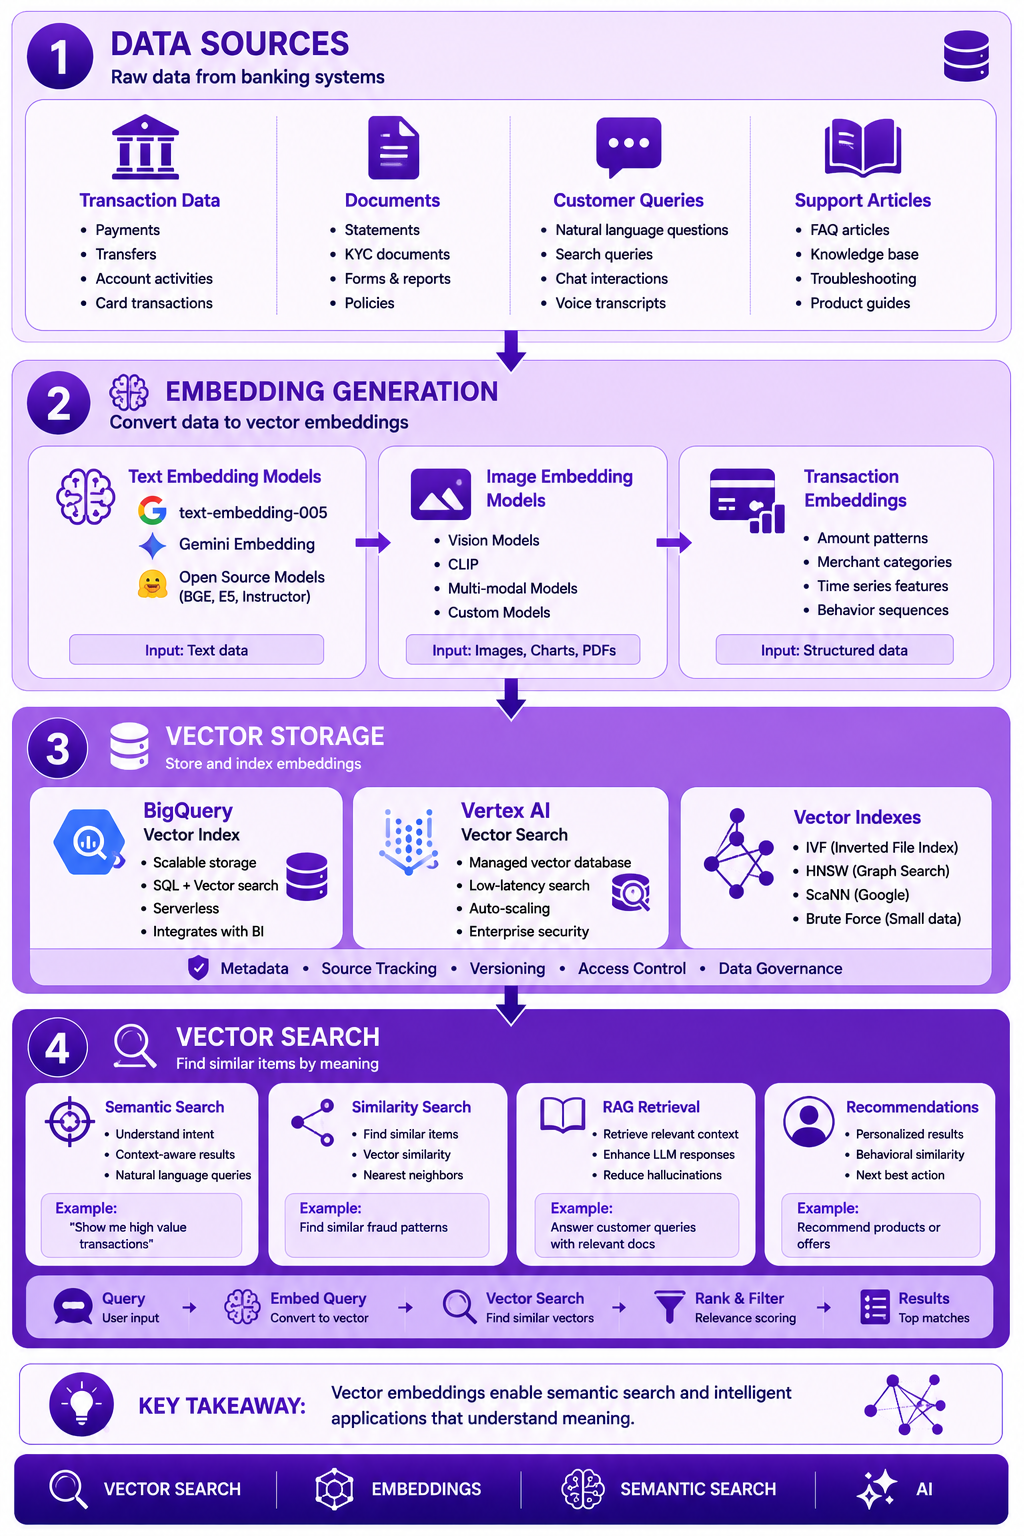
Prompt: Create a vector embeddings and search diagram showing the complete flow from data to search results. Use a 4-layer structure with purple gradient theme:
Layer 1: Data Sources (Top) - Purple #E1BEE7
- Transaction Data, Documents, Customer Queries, Support Articles
- Icons for each source
- Description: "Raw data from banking systems"
Layer 2: Embedding Generation - Purple #CE93D8
- Text Embedding Models (text-embedding-005, Gemini, Open Source)
- Image Embedding Models, Transaction Embeddings
- Icons for ML models
- Description: "Convert data to vector embeddings"
Layer 3: Vector Storage - Purple #AB47BC
- BigQuery Vector Index, Vertex AI Vector Search
- Vector Indexes (IVF, HNSW, ScaNN)
- Icons for storage
- Description: "Store and index embeddings"
Layer 4: Vector Search (Bottom) - Purple #7B1FA2
- Semantic Search, Similarity Search, RAG Retrieval, Recommendations
- Icons for search
- Description: "Find similar items by meaning"
Use downward arrows between layers. Include key takeaway at bottom: "Vector embeddings enable semantic search and intelligent applications that understand meaning." Footer tags: Vector Search, Embeddings, Semantic Search, AI. Enterprise-style clean layout with rounded corners.
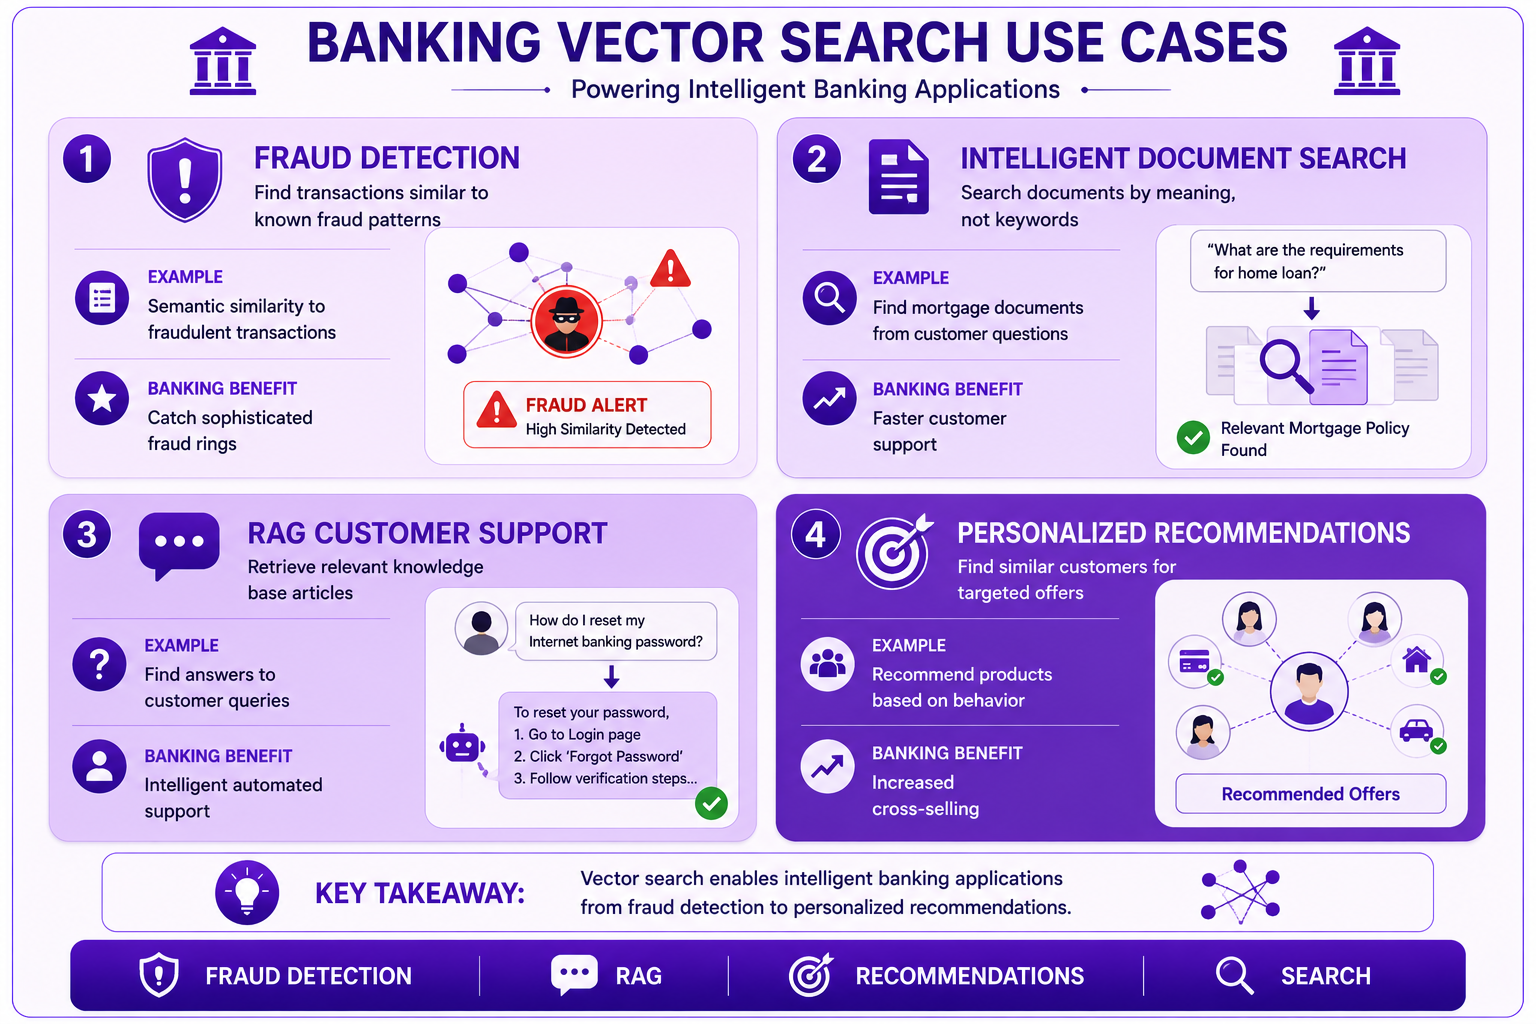
Prompt: Create a banking vector search use cases diagram showing four key applications. Use a 4-quadrant structure with purple gradient theme:
Quadrant 1: Fraud Detection (Top Left) - Purple #E1BEE7
- Title: "Fraud Detection"
- Icon: 🛡️
- Description: "Find transactions similar to known fraud patterns"
- Example: "Semantic similarity to fraudulent transactions"
- Banking Benefit: "Catch sophisticated fraud rings"
- Visual: Fraud alert icon
Quadrant 2: Document Search (Top Right) - Purple #CE93D8
- Title: "Intelligent Document Search"
- Icon: 📄
- Description: "Search documents by meaning, not keywords"
- Example: "Find mortgage documents from customer questions"
- Banking Benefit: "Faster customer support"
- Visual: Document search icon
Quadrant 3: Customer Support RAG (Bottom Left) - Purple #AB47BC
- Title: "RAG Customer Support"
- Icon: 💬
- Description: "Retrieve relevant knowledge base articles"
- Example: "Find answers to customer queries"
- Banking Benefit: "Intelligent automated support"
- Visual: Chat bubble icon
Quadrant 4: Recommendations (Bottom Right) - Purple #7B1FA2
- Title: "Personalized Recommendations"
- Icon: 🎯
- Description: "Find similar customers for targeted offers"
- Example: "Recommend products based on behavior"
- Banking Benefit: "Increased cross-selling"
- Visual: Recommendation icon
At bottom: Key takeaway: "Vector search enables intelligent banking applications from fraud detection to personalized recommendations." Footer tags: Fraud Detection, RAG, Recommendations, Search. Enterprise-style clean layout with rounded corners.
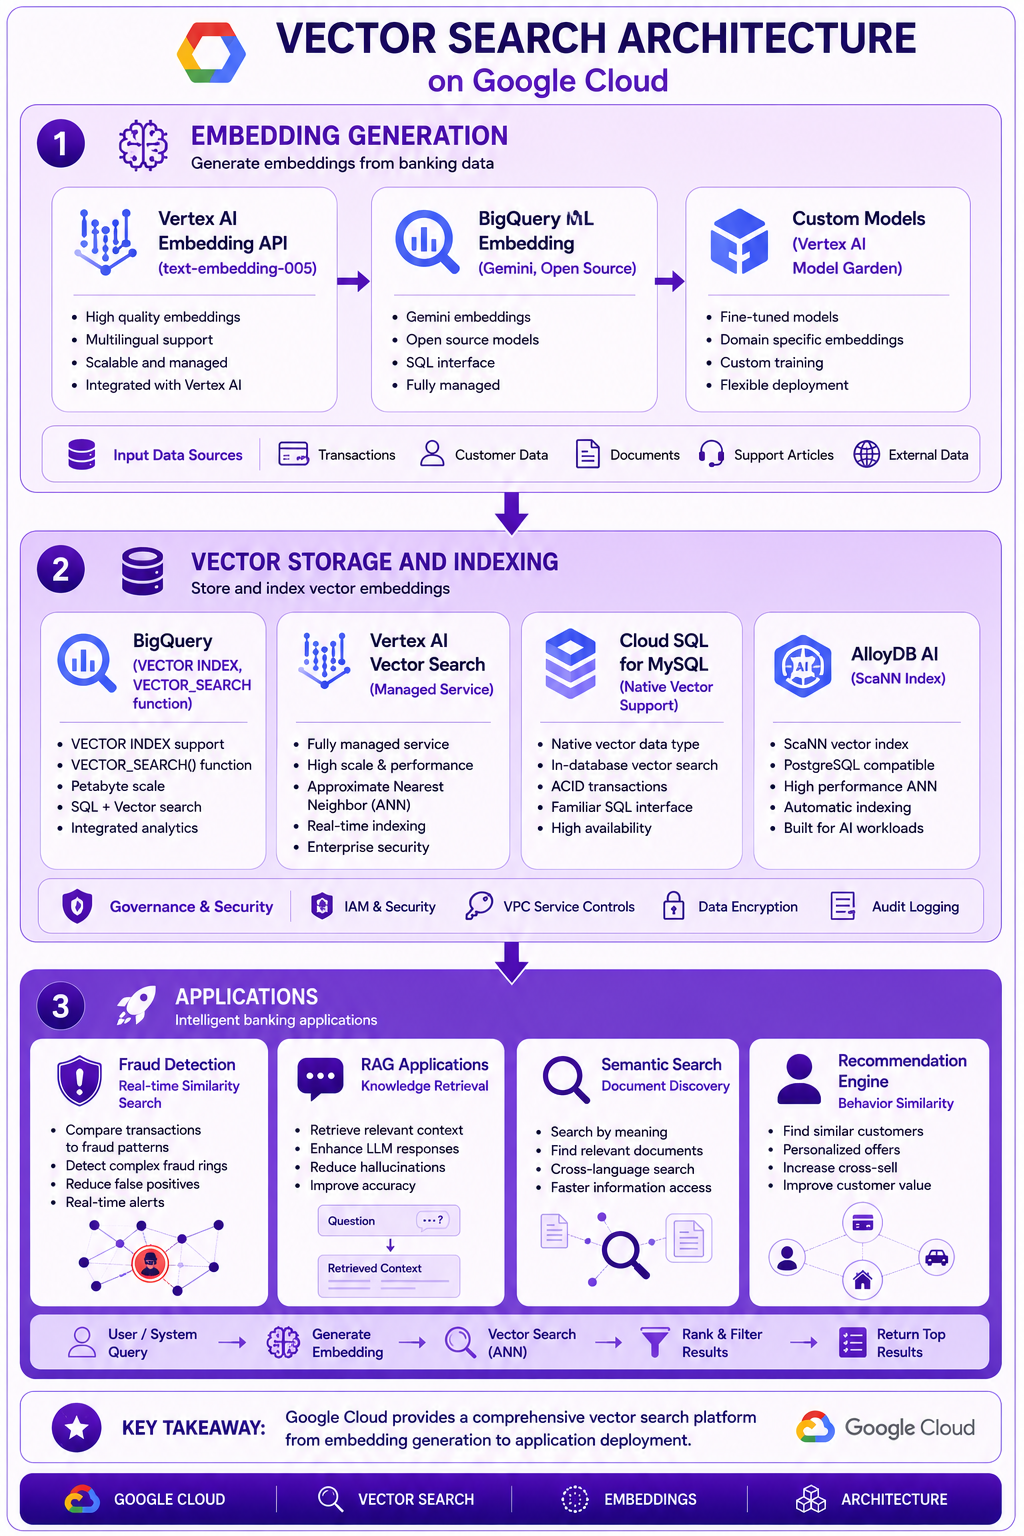
Prompt: Create a vector search architecture diagram showing Google Cloud services. Use a 3-layer structure with purple gradient theme:
Layer 1: Embedding Generation (Top) - Purple #E1BEE7
- Vertex AI Embedding API (text-embedding-005)
- BigQuery ML Embedding (Gemini, Open Source)
- Custom Models (Vertex AI Model Garden)
- Icons for AI/ML
- Description: "Generate embeddings from banking data"
Layer 2: Vector Storage and Indexing - Purple #CE93D8
- BigQuery (VECTOR INDEX, VECTOR_SEARCH function)
- Vertex AI Vector Search (Managed Service, High Scale)
- Cloud SQL for MySQL (Native Vector Support)
- AlloyDB AI (ScaNN Index)
- Icons for databases
- Description: "Store and index vector embeddings"
Layer 3: Applications (Bottom) - Purple #AB47BC
- Fraud Detection (Real-time Similarity Search)
- RAG Applications (Knowledge Retrieval)
- Semantic Search (Document Discovery)
- Recommendation Engine (Behavior Similarity)
- Icons for applications
- Description: "Intelligent banking applications"
Use downward arrows between layers. Include key takeaway at bottom: "Google Cloud provides a comprehensive vector search platform from embedding generation to application deployment." Footer tags: Google Cloud, Vector Search, Embeddings, Architecture. Enterprise-style clean layout with rounded corners.
Interview Questions
-
What are vector embeddings and why are they important?
-
How does vector search differ from keyword search?
-
What are the key embedding models available on Google Cloud?
-
How do you generate embeddings in BigQuery?
-
What is the difference between BigQuery Vector Search and Vertex AI Vector Search?
-
How do you create a vector index in BigQuery?
-
What are the different index types and when should you use each?
-
How do you use vector search for fraud detection?
-
What is RAG and how does vector search enable it?
-
How do you optimize vector search performance?
-
What are the best practices for embedding generation?
-
How do you monitor embedding quality?
Practice Exercises
-
Generate embeddings for banking transactions in BigQuery.
-
Create a vector index for semantic search.
-
Implement fraud detection using similarity search.
-
Build a RAG system for customer support.
-
Create personalized recommendations using customer embeddings.
-
Compare different embedding models for quality.
-
Implement metadata filtering in vector search.
-
Monitor embedding quality and drift.
-
Export embeddings to Vertex AI Vector Search.
-
Build a semantic document search application.
Key Takeaways
| # | Takeaway |
|---|---|
| 1 | Vector embeddings capture semantic meaning |
| 2 | Vector search finds similar items by meaning |
| 3 | BigQuery provides native vector search capabilities |
| 4 | Vertex AI Vector Search offers high-scale serving |
| 5 | Multiple index types for different needs |
| 6 | Vector search enables fraud detection and RAG |
| 7 | Embedding quality must be monitored |
| 8 | Google Cloud provides end-to-end vector search platform |
Chapter Summary
In this chapter, you learned:
- ✅ What vector embeddings are and how they work
- ✅ Embedding models on Google Cloud
- ✅ Generating embeddings in BigQuery
- ✅ BigQuery Vector Search implementation
- ✅ Vertex AI Vector Search for high-scale serving
- ✅ Banking use cases (fraud detection, RAG, recommendations)
- ✅ Vector index types and optimization
- ✅ Best practices and common mistakes
You now understand how to implement vector search and embeddings for intelligent banking applications.
Next Chapter
👉 Next Chapter: Knowledge Graphs and RAG